「請推薦洗碗機」這個問題,SIGO指數系統7月的月報累積了26次真實瀏覽器觀測,Bosch出現25次,出現率96%。同一句話、同一個品牌,我們另外透過API測了18次,只出現11次,61%。
兩個數字之間差了35個百分點。這不是抽樣誤差能解釋的範圍,而是兩種觀測方式本身,會產出兩份內容不同的報告。
這篇文章記錄我們實測到的差距在哪裡、規律是什麼。完整月報在這裡:洗碗機首發榜 Bosch甩開第二名27分。
六個品類的對照:落差與品牌集中度成反比
一個品類看不出規律,我們找了橫跨消費品牌與在地服務業的六個品類,用現成的瀏覽器月報數字,加測對應的API:
| 品類 | 龍頭品牌 | 瀏覽器月報(整月) | API | 落差 |
|---|---|---|---|---|
| 吸塵器 | Dyson | 100% | 100%(4/4) | 0 |
| 洗衣機 | LG | 100% | 75%(3/4) | -25 |
| 洗碗機 | Bosch | 96% | 61%(11/18) | -35 |
| 貓乾糧 | Orijen | 58% | 25%(1/4) | -33 |
| 台北律師 | 喆律 | 64% | 0%(0/4) | -64 |
| 台中醫美 | 佳立 | 50% | 0%(0/4) | -64 |
(▲洗碗機為主測品類(API18次),其餘五品類為方向性對照(各4次),用於檢驗規律是否跨品類成立。)
六個品類呈現一致方向:品牌集中度越高,兩種測法越一致。Dyson在吸塵器市場的地位壓倒性到怎麼問都躲不掉,落差是0。
只要龍頭沒有那麼壓倒性,API開始漏;到了在地服務業,API連測四次一次都沒提到龍頭的名字,但瀏覽器版有一半以上的機率會提到。
換句話說,如果品牌不是一家獨大,用API做能見度監測,很可能看到「AI完全不推薦我」的假象。離消費品牌越遠、越靠近在地服務業,這個假象越嚴重。
落差的第一個來源:AI要不要真的上網查,是機率問題
我們拿「請推薦洗碗機」測了三種情境:
| 問法 | 樣本數 | 實際觸發搜尋 | 引用來源數 | 內容特徵 |
|---|---|---|---|---|
| 裸模型(無搜尋工具) | 3次 | 0/3 | 永遠0個 | 憑訓練知識列出Bosch、Miele等國際大廠,會反問「你在哪個國家」 |
| 有搜尋工具,預設行為 | 7次 | 1/7 | 6次為0,查了的那次給9個 | 多數回答僅25至80字,只反問規格;唯一觸發搜尋的那次才提到台灣品牌與通路 |
| 真實瀏覽器 | 13次 | 11/13 | 平均1.3個 | 穩定給出台幣價格與台灣通路連結 |
(▲瀏覽器數據取自當月26次觀測中搜尋行為可判讀的13次。)
中間那一行是關鍵:API呼叫時搜尋功能技術上是開著的,但沒有額外設定時,模型自行決定是否動用,而它有86%的機率選擇不用。
瀏覽器版有85%的機率真的去查,不是背後模型比較聰明,是ChatGPT、Gemini的產品團隊針對「一般使用者打開網頁問問題」這個情境做過大量調校。這是產品端的成果,API裸調用不會繼承。
此外,還有結構性障礙,無法透過API程式設定來解決。
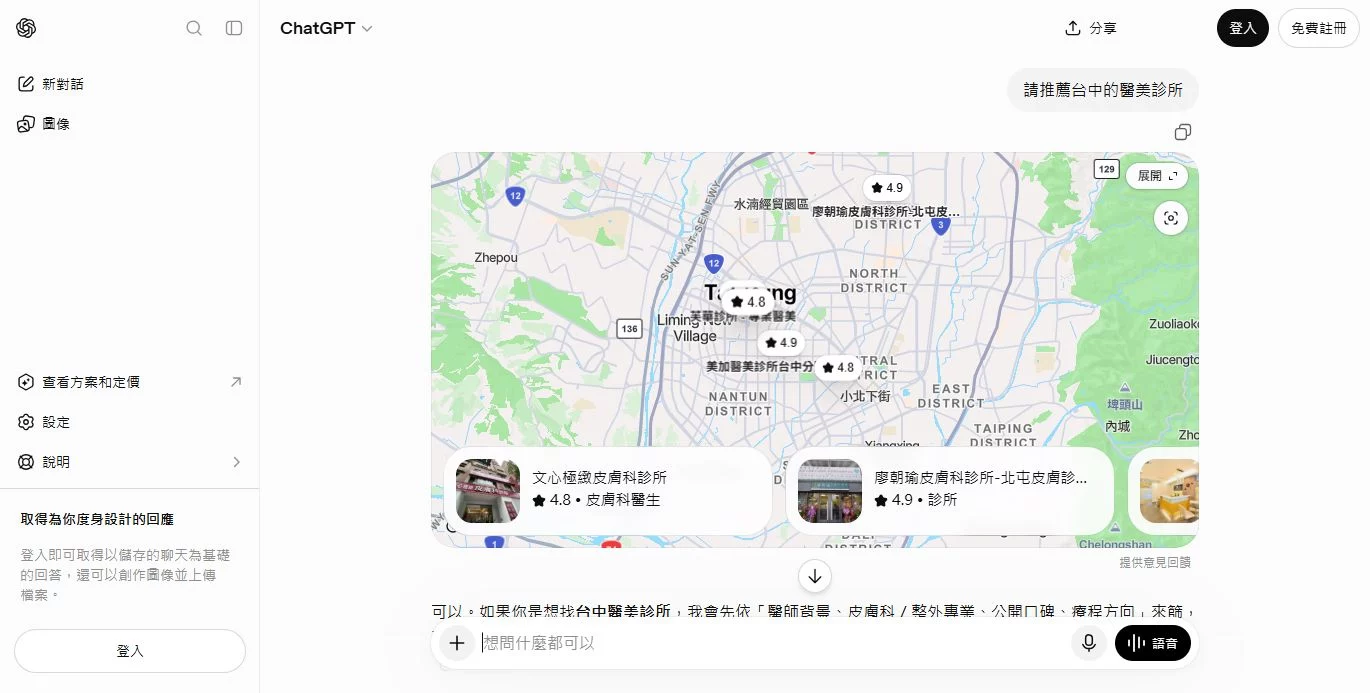
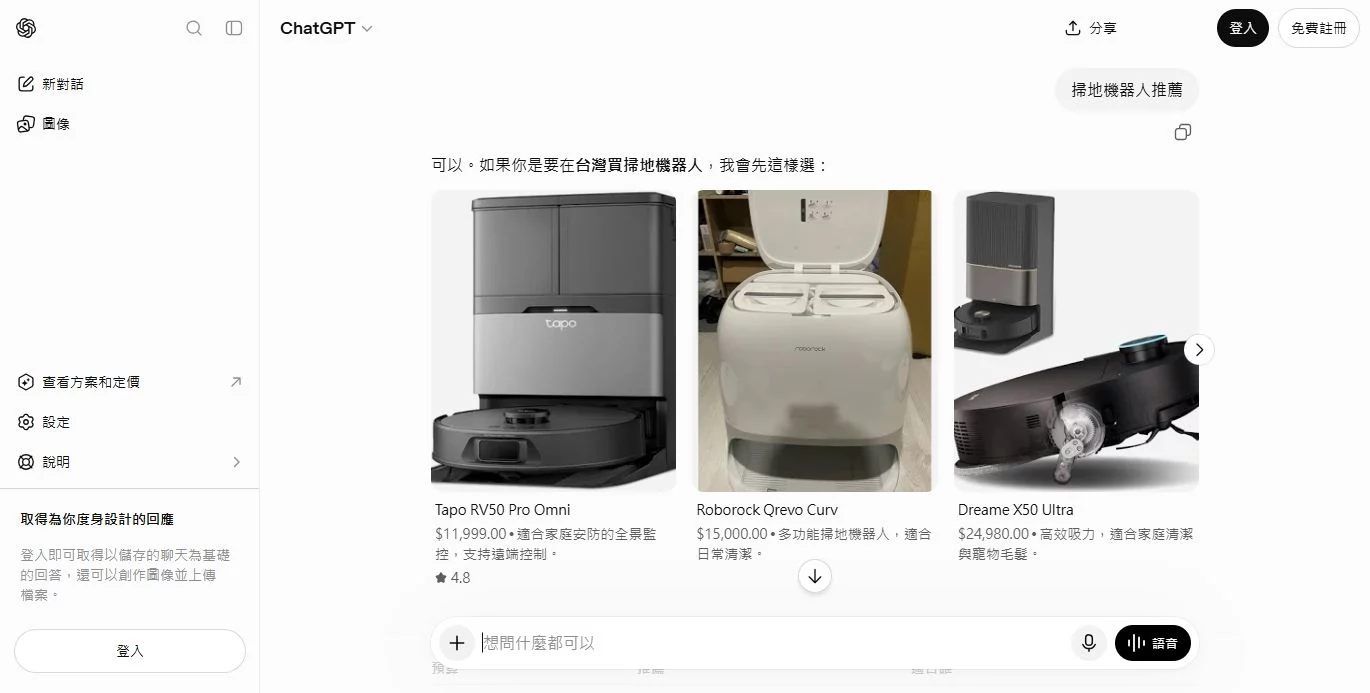
結構性差異一:畫面元件在API回應裡不存在
打開真實瀏覽器之後看到的畫面,才是決定性的差距。
以下是實際截圖,非示意圖。
ChatGPT問「請推薦台中的醫美診所」,跳出互動地圖,有店家定位釘、星等、照片:
ChatGPT問「掃地機器人推薦」,顯示可左右滑動的商品輪播卡片,含圖片、價格、星等:
ChatGPT問「請推薦貓砂品牌」,顯示結構化比較表,每列附來源徽章:
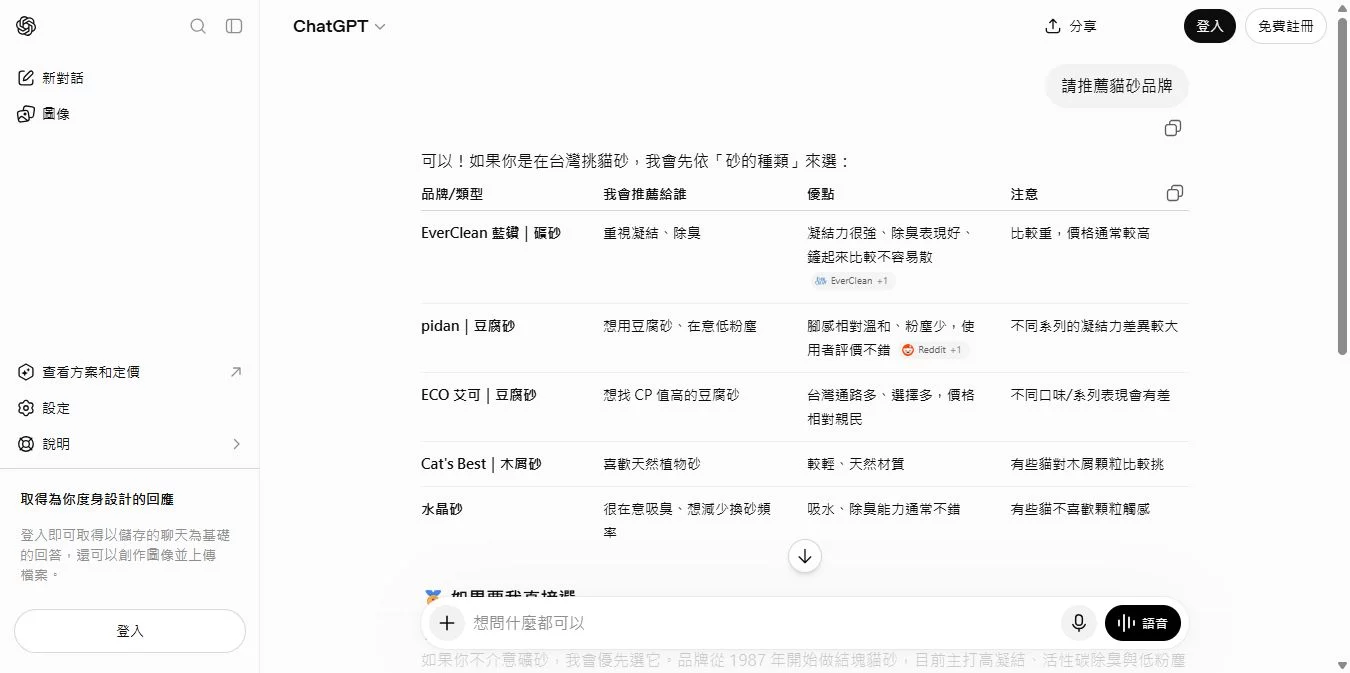
這些是產品團隊為購買決策設計的元件。API回應裡拿到的永遠是一段文字,問幾次都不會有地圖、商品卡、比較表。
這代表:就算AI文字裡提到了某個品牌,真實用戶「有沒有看到、會不會被吸引、會不會點進去」,與這段文字有沒有被API抓到,是兩件事。API能測「有沒有被提到」,測不到「被提到時呈現成什麼樣子」。
結構性差異二:多數消費者用的不是旗艦模型
我們的瀏覽器測試不登入任何付費帳號。實測畫面顯示,Gemini網頁版右下角標示的預設模型是Flash-Lite:
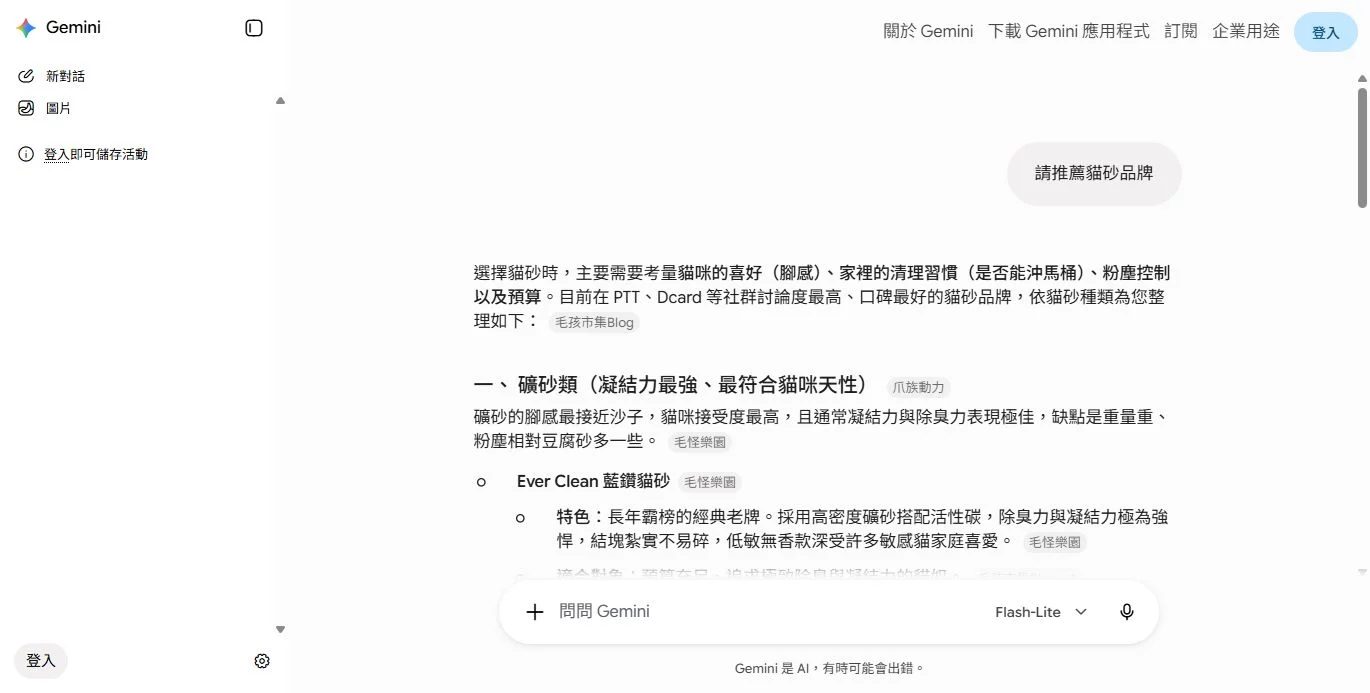
而技術測試者在API裡通常會指定更完整的正規版模型。多數真實消費者並不知道、也不會主動切換自己用的是哪個版本,他們接觸到的就是產品端配置的預設模型。
結果是:API測出來的回答,某種程度上比多數真人實際體驗到的更「聰明」。這是另一層失真——連的網不一樣,拿到的模型也不一樣。
觀測方法交代
我們的觀測全程模擬一般使用者的乾淨環境,避免對話歷史造成偏差。
把三層差距疊起來看:搜尋觸發是機率問題、畫面元件API拿不到、多數消費者用的是預設輕量模型。API測出的「AI能見度」,與消費者打開ChatGPT、Gemini實際看到的東西,是兩份不同的報告。
下次看到任何一份「品牌AI能見度」報告,可以先問一句:這是打API測出來的,還是真的有瀏覽器打開畫面看過?答案不同,該相信的程度也不同。