台中律師AI大亂戰 博策靠穩定曝光勝出

AI推薦觀測 第1輪 2026-07-06

ChatGPT Perplexity Gemini |歷史觀測共1輪

為了解AI如何向使用者推薦品牌,本輪報告模擬不同使用者、透過真實瀏覽器環境,向三大AI平台提出相同問題:

台中律師推薦

我們記錄各平台的完整回答,以及各品牌在不同平台中的曝光與推薦情形。

1
AI共識品牌數
出現≥2個AI
0%
全平台一致率
所有AI同時推薦
20%
前三名共識占比
相對共識集中度
0
本輪新進榜
vs上輪觀測
📋 本輪觀測摘要

本次觀測最關鍵的發現是:三大AI平台對台中律師的推薦名單幾乎沒有交集——共識排行榜前20名中,唯一跨越兩平台的只有「博策法律事務所」(Gemini與Perplexity同時推薦),其餘品牌皆僅出現於單一平台。這意味著AI對台中律師市場尚未形成穩定共識,任何事務所要建立跨平台能見度,都還有極大空間可以經營。博策以平均排名6.0奪得共識分數第一,但這其實是在「無強勢壟斷者」的市場下,以穩定曝光勝出的結果,而非壓倒性口碑優勢。三家第二名(明冠、亞細亞、喆律)各自在單一平台拿下第1名,反映出各AI的推薦邏輯與資料來源存在明顯差異,品牌若想全面佈局,需針對不同平台的偏好分別優化內容策略。

💡 本輪發現
›三大AI平台推薦名單高度分歧,20個品牌中僅博策一家跨平台出現,顯示台中律師市場在AI層面尚無公認強勢品牌,先佈局多平台的業者將享有先行者優勢。
›Gemini是本次最具個性化的推薦平台,不僅提供依專長分類的詳細名單,還特別強調律師的前職背景(如前法官助理),顯示Gemini更傾向以「資歷敘事」作為推薦依據。
›邱竑錡同時以「邱竑錡」與「邱竑錡律師」兩種寫法分別出現在Perplexity與Gemini的名單,卻被系統視為兩個不同條目,暴露出AI在個人律師品牌識別上的一致性缺口,個人執業者應強化品牌名稱的統一標準化。
›共識分數第一的博策法律事務所平均排名僅6.0,遠低於第2至4名的1.0,說明「跨平台出現」與「單平台高排名」是截然不同的兩種能見度策略,事務所應釐清自身目標是廣度曝光還是深度首推。
SIGO觀測 2026年7月・第1輪
ChatGPT、Perplexity、Gemini
台中律師推薦
👑
博策法律事務所
AI共識冠軍
🥈 共識第2名:明冠聯合法律事務所
🥉 共識第3名:亞細亞國際法律事務所
本輪觀測中,博策法律事務所以最高分拿下共識榜首。
至少2個AI平台皆提及才會出現本卡片
台灣AI市場觀測機構 記錄AI如何推薦品牌
SIGO觀測 sigotw.com
🏆 AI共識排行榜 共27個品牌

本輪前3名合計拿下全部共識分數的20%,其中第1名博策法律事務所以3分的差距領先第2名。

分數越高,代表這個品牌不只被AI提到,而且更常出現在推薦名單的前段。

分數差距越大,代表AI對推薦品牌的共識越明顯。

分數代表「AI有多常把這個品牌排在前面」。

每次回答中名次愈前面分數愈高(第1名10分,遞減至第10名1分,10名以後不計分),全部加總後換算成百分制。

詳細說明→

手機請左右滑動查看表格→

排名品牌共識分數出現次數出現平台平均排名
1博策法律事務所
40
2/0(0%)GemPplx 2/3#6.0
2明冠聯合法律事務所
37
1/0(0%)GPT 1/3#1.0
3亞細亞國際法律事務所
37
1/0(0%)Pplx 1/3#1.0
4喆律法律事務所
37
1/0(0%)Gem 1/3#1.0
5理眾國際法律事務所
33
1/0(0%)GPT 1/3#2.0
6張珮琪律師
33
1/0(0%)Gem 1/3#2.0
7理白國際法律事務所
30
1/0(0%)GPT 1/3#3.0
8威仁法律事務所
30
1/0(0%)Pplx 1/3#3.0
9賴佳郁律師
30
1/0(0%)Gem 1/3#3.0
10周仲鼎聯合律師事務所
27
1/0(0%)GPT 1/3#4.0
11劉維濬
27
1/0(0%)Pplx 1/3#4.0
12廖國佑律師
27
1/0(0%)Gem 1/3#4.0
13蘗樂法律事務所
23
1/0(0%)GPT 1/3#5.0
14邱竑錡
也曾出現為:邱竑錡律師
23
1/0(0%)Pplx 1/3#5.0
15邱竑錡律師
23
1/0(0%)Gem 1/3#5.0
16晉凱法律事務所
20
1/0(0%)GPT 1/3#6.0
17王培安律師
20
1/0(0%)Gem 1/3#6.0
18林淇羨
17
1/0(0%)GPT 1/3#7.0
19張方駿律師
17
1/0(0%)Gem 1/3#7.0
20趙若竹
13
1/0(0%)GPT 1/3#8.0

本次排行反映AI當下的推薦結果,想了解品牌在整個月的推薦穩定度、平台差異與排名變化,可進一步參閱SIGO台中律師指數報告。

📊 各AI推薦差異 前15名

本輪15個上榜品牌中,有14個只有單一平台推薦。

表中數字是該品牌在該平台被排到的名次,✓代表有被提到但沒有進入推薦順序。

品牌ChatGPTPerplexityGemini覆蓋
博策法律事務所✗✓✓2/3
明冠聯合法律事務所✓✗✗1/3
亞細亞國際法律事務所✗✓✗1/3
喆律法律事務所✗✗✓1/3
理眾國際法律事務所✓✗✗1/3
張珮琪律師✗✗✓1/3
理白國際法律事務所✓✗✗1/3
威仁法律事務所✗✓✗1/3
賴佳郁律師✗✗✓1/3
周仲鼎聯合律師事務所✓✗✗1/3
劉維濬✗✓✗1/3
廖國佑律師✗✗✓1/3
蘗樂法律事務所✓✗✗1/3
邱竑錡✗✓✗1/3
邱竑錡律師✗✗✓1/3
🔍 AI回答重點 AI最在意的評估面向
律師事務所推薦1案件類型專長1台中地區律師1法律服務評價1專精領域分類1律師推薦與選擇1案件類型分類1律師專長領域1台中地區律師資訊1律師篩選標準1

顏色越深代表出現頻率越高

🏷️ 品牌定位印象 AI如何描述各品牌
博策法律事務所
跨平台穩定曝光、綜合民刑事
明冠聯合法律事務所
ChatGPT首推、訴訟實績導向
亞細亞國際法律事務所
Perplexity首推、高評論基數、多元服務
喆律法律事務所
Gemini首推、家事大型團隊、全台品牌
理眾國際法律事務所
刑事辯護與家事複合專長
張珮琪律師
前法官助理資歷、家事親權同理取向
理白國際法律事務所
免費諮詢入口、民刑行政家事全覆蓋
威仁法律事務所
台中在地團隊、Perplexity主推
賴佳郁律師
家暴性平專案、情感支持型法律服務
周仲鼎聯合律師事務所
法院周邊地利、時間彈性、在地諮詢
📸 AI實際回答畫面 AI回答首屏截圖
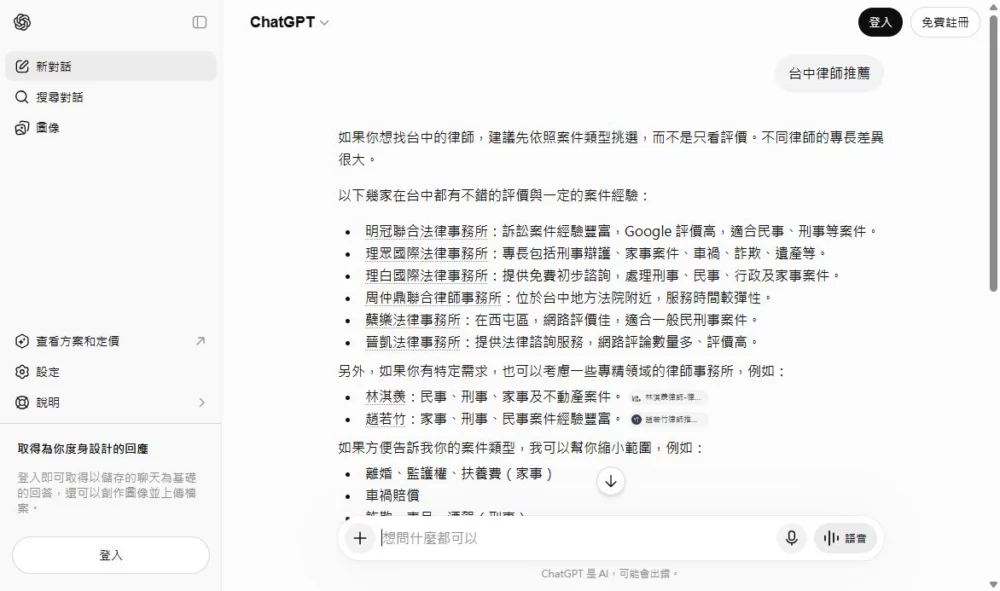
ChatGPT
台中律師推薦
台中律師推薦
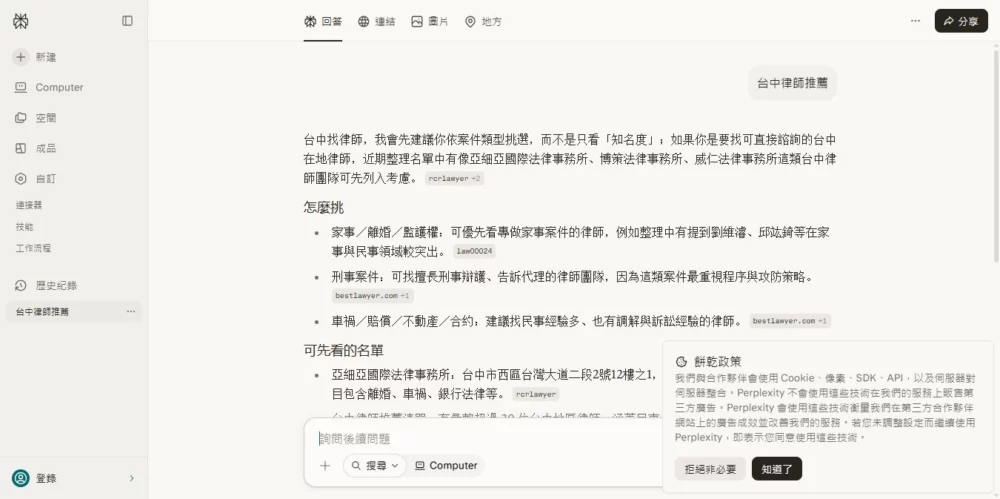
Perplexity
台中律師推薦
台中律師推薦
📄 AI完整回答 點擊展開各題原始回答

AI回答完整保留,僅做排版以利閱讀,全部未經增刪修改;商品卡片、地圖等互動元件僅轉錄其文字資訊,原始樣貌可參照截圖。

ChatGPT
台中律師推薦

如果你想找台中的律師,建議先依照案件類型挑選,而不是只看評價。不同律師的專長差異很大。

以下幾家在台中都有不錯的評價與一定的案件經驗:

  • 明冠聯合法律事務所:訴訟案件經驗豐富,Google 評價高,適合民事、刑事等案件。
  • 理眾國際法律事務所:專長包括刑事辯護、家事案件、車禍、詐欺、遺產等。
  • 理白國際法律事務所:提供免費初步諮詢,處理刑事、民事、行政及家事案件。
  • 周仲鼎聯合律師事務所:位於台中地方法院附近,服務時間較彈性。
  • 蘗樂法律事務所:在西屯區,網路評價佳,適合一般民刑事案件。
  • 晉凱法律事務所:提供法律諮詢服務,網路評論數量多、評價高。

專精領域律師事務所

另外,如果你有特定需求,也可以考慮一些專精領域的律師事務所,例如:

  • 林淇羨:民事、刑事、家事及不動產案件。
  • 趙若竹:家事、刑事、民事案件經驗豐富。

常見案件類型

如果方便告訴我你的案件類型,我可以幫你縮小範圍,例如:

  • 離婚、監護權、扶養費(家事)
  • 車禍賠償
  • 詐欺、毒品、酒駕(刑事)
  • 債務、借款、合約(民事)
  • 勞資糾紛
  • 遺產繼承
  • 房地產糾紛
  • 公司、商業法律

我可以依你的情況推薦更適合的台中律師。

Perplexity
台中律師推薦

台中律師選擇建議

在台中找律師時,建議先依案件類型挑選,而不是只看「知名度」。如果你是要找可直接諮詢的台中在地律師,可先將以下律師團隊列入考慮:

  • 亞細亞國際法律事務所
  • 博策法律事務所
  • 威仁法律事務所

依案件類型選擇律師

家事/離婚/監護權:可優先看專做家事案件的律師,例如劉維濬、邱竑錡等在家事與民事領域較突出。

刑事案件:可找擅長刑事辯護、告訴代理的律師團隊,因為這類案件最重視程序與攻防策略。

車禍/賠償/不動產/合約:建議找民事經驗多、也有調解與訴訟經驗的律師。

台中律師事務所詳情

亞細亞國際法律事務所

  • 地址:台中市西區台灣大道二段2號12樓之1
  • 評價:4.9(評論 395 則)
  • 服務項目:離婚、車禍、銀行法律等

博策法律事務所

  • 服務項目:家事、刑事、民事與企業顧問等多元案件類型

威仁法律事務所

  • 服務項目:家事、民事、刑事都有實務經驗
  • 特色:提供委託人回饋與成功案例

選擇律師的建議做法

建議先把你的案件類型講清楚,然後比較以下三件事:

  • 專長是否對口
  • 是否有台中在地辦案經驗
  • 是否能提供初談與收費說明

如果你要縮小到「離婚/車禍/刑事/遺產」其中一類,可進一步整理成更精準的台中律師名單。

想看整個品類的長期推薦格局?

單輪觀測看當下,完整月報看整體趨勢。

📊 全品牌穩定度總表:看哪些品牌穩定被推薦,哪些只是偶爾出現
🔀 三大AI平台拆解:找出不同AI的推薦差異與品牌缺席
🔗 AI引用來源分析:了解AI推薦背後引用了哪些內容與網站

查看觀測整個月的SIGO台中律師指數→

🔬 我們如何進行本輪觀測

本報告運用SIGO自主研發的AI觀測技術,以真實瀏覽器環境進行觀測,而非僅透過API擷取模型回覆,盡可能貼近一般使用者的實際使用情境,更真實地呈現品牌在AI中的曝光與推薦表現。

觀測過程會模擬不同使用情境,向各AI平台提出相同問題,完整記錄回答內容、引用來源、品牌提及情形與推薦理由,再進行交叉分析與整理。

由於AI的回答可能受到模型版本、個人化設定、登入狀態、地區、時間及系統更新等因素影響,因此本報告反映的是觀測期間的實際結果,而非永久固定的答案。

AI正在推薦什麼品牌?

SIGO每週把最新的AI推薦觀測整理給你。
新出現的品牌、推薦排名的變化、AI正在看重什麼?

追蹤SIGO觀測

SIGO觀測是一個獨立的AI推薦觀測機構,持續記錄ChatGPT、Gemini、Perplexity等AI平台在回答消費者提問時,實際提及與推薦了哪些品牌。

我們觀測的對象是整個產業與品類內的所有品牌,而不是單一品牌自己的表現,就像媒體記錄市場動態,而不是幫特定公司做自我檢測。

多數AI能見度工具是品牌方拿來查看自己在AI中的曝光狀況,SIGO觀測的角色不同:我們持續掃描每個品類中所有主要品牌被AI提及的情況,建立跨品牌、跨期的完整觀測紀錄。

SIGO觀測採用大量真實瀏覽器環境搭配台灣本地網路進行觀測,以固定方法與固定週期產出品類指數與觀測報告,讓任何人都能看見整個產業的AI推薦格局,而不只是單一品牌的片面數據。

因為真實環境、真實瀏覽器,就等於是真實網友實際問AI看到的答案和畫面,而不是一般串API跑出來的答案。

國內外多數AI能見度工具是透過API直接呼叫模型取得回答,但API回傳的內容與消費者在ChatGPT、Gemini、Perplexity等介面上實際看到的畫面並不相同,且會因為API使用的模型不同,差距更大。

真實介面中的購物卡片、引用來源、在地化價格與品牌排序,往往是API呼叫無法完整重現的層面,API觀測與真實環境觀測,測量的其實是兩種不同的對象。

SIGO觀測選擇採用大量不同用戶的真實瀏覽器環境進行觀測,搭配台灣本地網路環境執行查詢,記錄的是台灣消費者打開AI對話視窗時,實際會看到的推薦內容。

這個選擇讓觀測結果更貼近消費者的真實體驗,也是SIGO觀測與多數API觀測工具在方法論上的根本差異。

一般AI能見度檢測工具的邏輯是查詢自己的品牌,測量的原點永遠是你自己。如果品牌已經進入AI的回答,工具看到的是你的表現;如果尚未進入,看到的其實是別人的位置。

SIGO觀測從一開始就以第三方角度觀測整個產業,如實呈現業界現況,已經進入答案時參考價值更高,尚未進入時則能掌握業界趨勢。

除了以品牌為主角的觀測報告,SIGO觀測還提供跨產業視角的內容:趨勢洞察報告鎖定多個議題,記錄各產業話題的變化方向;SIGO指數報告則把品類內的觀測數字彙整成單一指數,呈現整體AI推薦環境的走勢。

這些內容幫助你掌握的不只是單一品牌的位置,而是整個商業環境的脈動。

可以。只要品牌所屬的品類在SIGO觀測範圍內,你的品牌就會持續被收錄,累積出現次數、涵蓋品類與最新一次收錄紀錄。如果你的行業或產品品類尚未涵蓋,也歡迎告訴我們,這是SIGO觀測擴充品類時重要的參考依據。

每個有進入觀測範圍的品牌都有專屬的品牌頁面,在AI答案中的表現若通過一定的門檻,我們會生成專屬的品牌檔案,彙整上月全月觀測數據,把該品牌在各品類中的AI推薦排行整理成單一頁面:涵蓋品類數與觀測次數、各品類的名次與AI推薦分數、名次波動與競爭品牌脈絡、AI在回答中如何描述這個品牌、以及所有提到這個品牌的相關報告列表,都會完整呈現。

需要提醒的是,SIGO觀測不是為單一品牌量身打造的檢測服務,我們記錄的是整個品類內所有品牌的表現,你的品牌只是其中之一。這個角度反而更有價值:你看到的不只是自己有沒有被AI提及,而是在同一個品類中,哪些品牌被提得多、哪些正在流失能見度,這些對照才是判斷自己實際處境的關鍵依據。

SIGO觀測的內容分成兩層。基礎層是持續產出的觀測報告,包含記錄各產業品牌實際被AI推薦情況的AI推薦觀測報告、觀察各產業話題與變化的AI趨勢洞察、以及彙整單一品牌在AI推薦中出現紀錄的品牌檔案,這三類報告構成SIGO觀測資料庫的核心。

在基礎層之上,SIGO各品類指數彙整上個月該品類的所有觀測,呈現推薦集中度與穩定度的變化;針對區域性比較強的品類例如台北補習班,則有區域性AI推薦榜來觀察在地品牌推薦情況,不計入總指數。

每期各品類指數再彙整為SIGO總指數,呈現整體AI推薦環境的變化方向,讓單一觀測數據最終串接成可長期追蹤的產業指標。

AI推薦觀測報告
記錄AI在各產業、各品類實際推薦了哪些品牌
AI趨勢洞察
觀察AI回答中的產業話題與市場變化
品牌檔案
累積單一品牌在不同品類、不同時期的AI出現紀錄
↓
SIGO各品類指數
將一段期間內的品類觀測累積為指數,觀察品牌推薦集中度與穩定度的變化
↓
區域性AI推薦榜
觀察特定地區的AI品牌推薦情況及其跨期變化
不匯入總指數
SIGO總指數
彙整各品類指數,觀察整體AI市場推薦環境的變化方向

我們的觀測題目都是以推薦意圖為核心的固定提問。因為「推薦」是消費決策前最高頻的查詢組合之一,也是品牌方最重視的關鍵字,可以視為品牌在AI市場中的「聖杯」:能夠穩定進入推薦名單,代表品牌已經具備一定程度的市場認知與AI推薦優勢。

此外,跨期比較要求題目恆定,題目一旦變動,數值的升降就無法區分是AI推薦傾向改變,還是提問方式改變。

平台選擇的依據是台灣使用者的實際接觸範圍,而非模型本身的技術評價。

SIGO記錄的是消費者可能真實接收到的推薦內容,因此納入標準是普及程度,不是能力排名。

ChatGPT在台灣的一般使用者滲透率最高,是多數人第一個接觸的AI對話工具。

Gemini依託Google既有的服務入口,在搜尋與行動裝置端擁有廣泛的自然觸及。

Perplexity則是兩大巨頭之外知名度最高的獨立平台,在資料查找與報告寫作場景中有明確的使用族群,而因其預設會先搜尋再回答,所以是GEO操作的重要參考平台。

其他平台目前不納入,原因各異。

Grok的主要入口X.com在台灣屬於相對小眾的社群平台,一般消費者接觸機會有限。

Claude在技術與網路社群中知名度高,但在一般消費族群中的普及程度尚未達到同等水準。這些判斷會隨市場變化重新評估,平台名單並非永久固定。

觀測平台的增減將視使用者接觸範圍的實際變化調整,任何調整都會在方法學說明中記錄變更時點,並在指數計算上維持前後期的可比處理。

五種內容對應五種不同的觀測單位:單次、跨期、地區、品牌、產業。理解差別最快的方式,是看它們各自回答什麼問題。

觀測報告:某一次觀測看到了什麼

以品類為單位,每次觀測完成即發布,記錄該次三個平台各自給出的品牌名單與排序。觀測序號累計不重置,是可回溯的原始記錄。

SIGO指數:跨期彙整和分析,展示這個產品類別的推薦格局如何變動

以品類為單位,將整月多次觀測結果彙整為單一數值,並以基期正規化。指數頁提供跨期比較、排名變動、平台間分歧來源等解讀,回答的是趨勢問題而非單次問題。

SIGO指數詳細說明

地區排行榜:同一服務在不同城市的推薦差異

適用於推薦結果會因地區而異的服務型品類,採城市層級分眾。排行榜為獨立產品,不納入SIGO總指數計算,避免地區樣本影響跨品類可比性。

品牌檔案:單一品牌在各品類的表現軌跡

以品牌為單位橫向彙整,呈現該品牌的歷史表現、被提及的品類分布、以及推薦來源結構。品牌檔案是查詢入口,觀測報告與指數則是它的資料來源。

被AI提及過的品牌不會自動建立檔案,需通過穩定度門檻,避免名單灌水而失去參考價值。

趨勢洞察:AI如何回答這個產業的消費疑問

以產業為單位,提出五題開放式問題,涵蓋風格趨勢、預算配置、選購考量等消費者實際會問的內容,記錄三個平台的完整回答並交叉分析。

洞察觀察的是論述內容而非品牌名次,因此不產生分數,也不進入指數計算。它回答的是AI對整個產業的認知框架正在如何移動。

五者的關係

觀測報告與趨勢洞察是兩條並行的原始層,前者問品牌,後者問議題。指數與品牌檔案都由觀測報告彙整而來,方向不同:指數往時間軸縱向累積,品牌檔案往品牌橫向收攏。地區排行榜自成一套,與總指數各自獨立。

不會,這也不是SIGO觀測要做的事。SIGO觀測的角色是記錄與呈現AI實際推薦了哪些品牌,而不是介入或改變AI的推薦結果,這個角色分際是SIGO觀測公信力的基礎。

不過,看得懂數據本身就有價值。

透過品牌檔案與品類指數,你可以清楚看到自己在哪些平台、哪些品類中被提及,AI又是用什麼方式描述你的品牌,這些觀測結果能幫助你判斷目前所處的位置,以及該採取的行動。

每份報告裡的共識分數、出現率、穩定度、SIGO指數,量的是不同層面的東西:

共識分數看AI多常把品牌排在前面。

出現率看AI提不提到這個品牌。

穩定度看提到的時候名次可不可靠、穩不穩定。

SIGO指數則是跨期統計和分析,方便掌握市場真正的變化。

共識分數 = 結果
出現率、覆蓋平台、平均排名 = 組成這個結果的細節
名次區間、穩定度 = 這個結果到底穩不穩

這幾個指標搭配著看,才能判斷一個品牌是穩定站上前段班,還是少數幾次剛好衝到前面。

完整說明與計算邏輯,可以參考SIGO觀測數據與排名說明大全。

最常見的誤會,是只憑感覺比較兩個品牌的曝光狀況,結果被公式的乘法效果搞混了。

共識分數其實可以拆解成:

共識分數(%)=出現率(%)×(平均每次出現拿到的積分÷10)

這代表出現率其實是分數的天花板:不管一個品牌每次出現時排名多好,只要出現率不夠高,分數就是衝不上去——因為公式把「沒出現的那幾次」算成0分,一起攤進分母裡。

舉個例子,同樣觀測10次:

品牌C:出現9次(出現率90%),但每次都排第9名(2分)→ 積分9×2=18分 → 共識分數18分。

品牌D:只出現4次(出現率40%),但每次都排第1名(10分)→ 積分4×10=40分 → 共識分數40分。

品牌D出現的次數比品牌C少一半以上,共識分數卻是品牌C的兩倍多。乍看「品牌C幾乎每次都出現,應該比較強」,但因為排名一直在後段,分數反而被拉低;品牌D雖然常常缺席,但只要出現就是第一名,含金量高,分數就上得去。

所以看到兩個品牌「感覺條件差不多」但分數差很多的時候,先分別去看它們的出現率和平均排名這兩個數字,答案通常就藏在這兩個數字的落差裡,不是共識分數算錯了。